MS-RAG
多源增强检索增强生成框架(Multi-Source Enhanced Retrieval-Augmented Generation Framework,MS-RAG)
本页是框架参考。想先了解索引和 agentic 检索循环的"为什么",请先读设计文档:
- 知识库索引原理——一篇文档如何变得可被检索:结构索引 / 知识图谱索引(含代码图谱) / 向量索引 / 关键词索引。
- Agentic RAG 对话原理——一个问题如何通过 agent 驱动的检索循环变成带引用的回答。
简介
大语言模型(LLM)虽然强大,但只能基于训练数据回答。当用户需要最新或领域专属信息——比如内部文档、自建数据库、最新报告——单靠 LLM 就不够了。
检索增强生成(RAG) 通过从外部知识源检索相关信息、作为上下文喂给 LLM 再生成回答来填补这一缺口,确保回答基于真实数据而非记忆中的模式。
DB-GPT 实现的 多源 RAG(MS-RAG) 框架远超基础文档问答:它支持多种知识源(文档、URL、数据库、知识图谱、git 仓库)、多种索引策略,并与 DB-GPT 的 agent 和工作流生态深度集成。知识库对话由 agentic RAG 循环完成——agent 可以改写问题、多次检索、融合并重排结果、产出带引用的回答——而不是单次"检索-生成"。
架构
两个阶段:索引与对话
索引(文档同步时执行)                          对话(聊天时执行)
─────────────────────                        ──────────────────────
知识源 → 切分 → 索引                          用户问题
        │                                            │
  一次切分,                                          ▼
  多种索引:                                 Agentic RAG 循环
   • 向量  • 关键词                        (改写问题 → 检索,可能多轮
   • 知识图谱(三元组、                          → 融合 + 重排 → 拼 prompt)
   •  文档-段落、Markdown 标题、                      │
   •  代码 AST)                                      ▼
                                          LLM 生成带引用的回答
索引与对话解耦:索引在文档同步时执行一次,对话时只检索,不重新索引。
索引流水线
构建索引是一条 ETL 流水线——一次"抽取"+ 一次"切分"喂给所有启用的索引;只有各索引自己的"转换"和"加载"不同。
抽取 Extract            转换 Transform                     加载 Load
─────────────           ──────────────────────             ───────────────────────
Knowledge.load()    →   ChunkManager.split()            →  持久化进索引存储
解析数据源 →              + 各索引自己的转换:                · EmbeddingAssembler   → 向量库
原始文本                  · embedding      (向量)           · BM25Assembler        → Elasticsearch
                         · 分词           (关键词/BM25)    · graph store + RepoGraphBuilder
                         · 三元组 / 标题 /                    → 图存储 / 代码图谱
                           代码 AST       (知识图谱)      · SummaryAssembler     → 向量库
                         · 摘要           (summary)        · DBSchemaAssembler    → 向量库
                         附上元数据(标题路径、
                          chunk_id …)供检索/引用
- 抽取(Extract) ——
KnowledgeFactory把每个数据源(文件/URL/文本/git 仓库)路由到对应的Knowledge实现,解析成原始文本(Knowledge.load())。 - 转换(Transform) ——
ChunkManager.split()按策略(大小/页/段落/分隔符/Markdown 标题)切分;每个索引再各自转换——embedding、BM25 分词、LLM 三元组/标题/代码 AST 抽取、摘要、schema embedding——并附上元数据(Header1…Header6、chunk_id…),后续检索和引用都靠它。 - 加载(Load) —— 按索引的驱动器把转换结果持久化进索引存储:向量/关键词/摘要/schema 索引分别由
EmbeddingAssembler/BM25Assembler/SummaryAssembler/DBSchemaAssembler写入;知识图谱与代码图谱由图存储(aload_document)+RepoGraphBuilder构建。(结构索引不加载——它在检索时按本阶段写入的HeaderN元数据重建。) - 检索与生成 —— 即下文的 agentic RAG 对话。
索引 ETL 流水线
BaseAssembler 定义了统一的"抽取 → 转换 → 加载"骨架,各索引插入各自的转换+加载。一次抽取 + 一次切分喂给所有启用的索引——只有转换+加载随索引不同而不同。
Knowledge.load()  →  ChunkManager.split()  →  Assembler.persist()  →  Assembler.as_retriever()
   # 抽取              # 转换                    # 加载                   # 检索(对话时)
| 索引 | 转换 | 加载驱动(实现) | 索引存储 |
|---|---|---|---|
| 向量 | chunk → embedding | EmbeddingAssembler.persist() | 向量库(Chroma、Milvus …) |
| 关键词 | chunk → BM25 分词 | BM25Assembler.persist() | Elasticsearch |
| 知识图谱 | chunk → LLM 三元组 + 文档/标题/代码 AST 图 | 图存储 aload_document + RepoGraphBuilder | TuGraph / Neo4j / Memgraph |
| 摘要 | chunk → LLM 摘要 → embedding | SummaryAssembler.persist() | 向量库 |
| 库表 schema | schema → embedding | DBSchemaAssembler.persist() | 向量库 |
| 代码图谱 | 代码 → tree-sitter AST | RepoGraphBuilder → CodeGraphStore | 代码图谱表 |
| 结构 | (无——检索时才建) | 检索时按 HeaderN 元数据建 DocTreeIndex | — |
各 assembler 是向量/关键词/摘要/schema 索引的加载阶段驱动器;知识图谱与代码图谱分别由图存储和
RepoGraphBuilder构建。它们消费的都是抽取+转换阶段产出的同一批 chunk——所以切分质量是所有索引的共同地基。
索引
DB-GPT 通过 index_methods(字符串列表)按知识空间选择要建哪些索引。三种索引方法是持久化的;结构索引和代码图谱是叠加在它们之上的两种形态。所有索引都作用在同一批 chunk 上,所以切分质量决定检索质量。
| 索引 | index_methods 值 | 同步时建? | 能给你什么 |
|---|---|---|---|
| 向量 | VectorStore | 是 | embedding + 余弦的语义相似度排序 |
| 关键词 | FullText | 是 | 精确词 / BM25 命中 |
| 知识图谱 | KnowledgeGraph | 是 | 对实体、文档结构、标题、代码做图遍历 |
| 结构 | (检索时建树) | 否,查询时按 chunk 的 HeaderN 元数据重建 | Markdown 标题树 / 父子章节导航 |
| 代码图谱 | (叠加在 KnowledgeGraph;也用于 GIT_REPO 空间) | 是 | 代码文件 AST,产出 function/class 节点 + defines 边 |
知识图谱索引不是一张图,而是一组图:LLM 抽取的三元组图、文档-段落结构图、Markdown 标题层级图,以及(代码/git 仓库场景下的)代码 AST 图。它们共用一条构建链路。细节与代码图谱的 tree-sitter 解析见知识库索引原理。
对话:agentic RAG
用户在知识库上提问时,DB-GPT 不是单次"检索-生成",而是由 agent 驱动循环:
问题
   │
   ▼
问题改写 / 多问题                          ◄── LLM 扩展问题以提升召回
   │
   ▼
检索(向量 + 关键词 + 图谱,可能多轮)      ◄── 可迭代:检索 → 判断 → 再检索
   │
   ▼
融合 + 重排
   │
   ▼
拼上下文,生成带引用的回答
正是这个 agentic 循环——多步检索、问题改写、结果融合重排、引用——让 DB-GPT 能回答单次 RAG 应付不了的复杂或多部分问题。完整流程见 Agentic RAG 对话原理。
检索策略
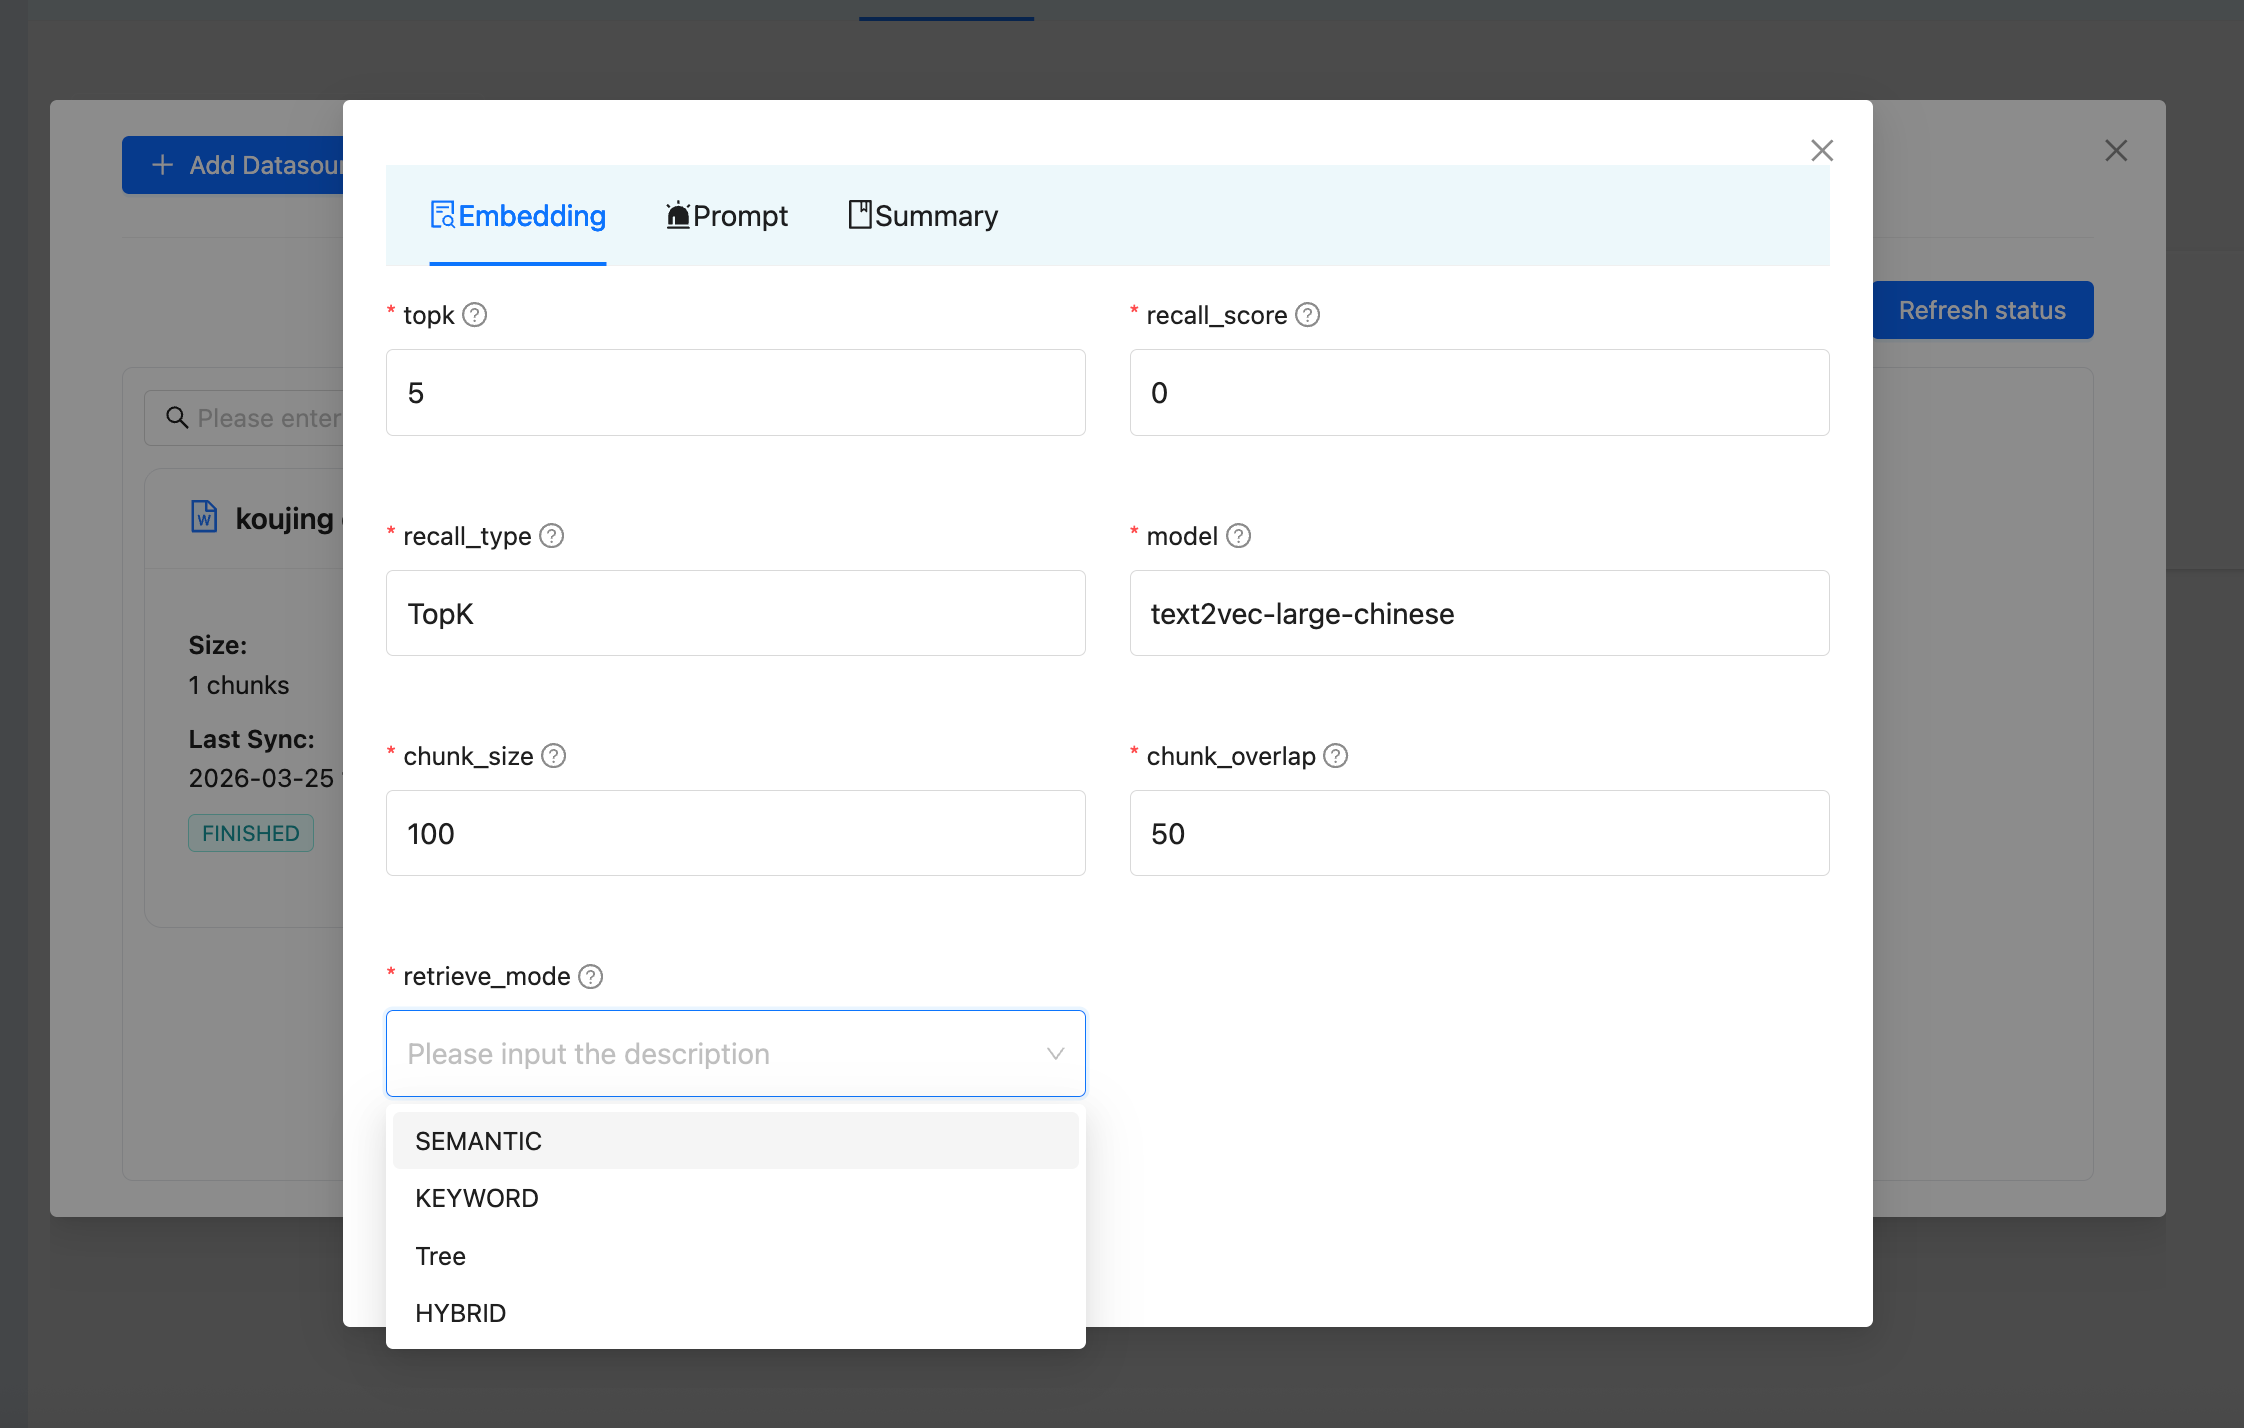
可在知识库设置里配置检索模式:
| 策略 | 描述 | 所需后端 |
|---|---|---|
| Semantic | 基于 embedding 的向量相似度检索 | 向量库 |
| Keyword | 基于 BM25 的关键词匹配 | Elasticsearch |
| Hybrid | 向量 + 关键词,用 RRF(倒数排名融合)合并 | 向量库 + Elasticsearch |
| Tree | 在 Markdown 标题层级上的树结构检索 | 向量库 |
查询增强
除原始检索外,agentic 循环还提供高级查询处理:
- 问题改写(Query Rewrite) —— 用 LLM 把原问题扩展/改写成多个检索问题以提升召回,并判断是否需要再检索一轮。
- 重排(Reranking) —— 检索后,用 reranker 重打分、重排结果再进 prompt,提升精度。
支持的重排器
| 重排器 | 类型 | 描述 |
|---|---|---|
| CrossEncoderRanker | 本地 | sentence-transformers CrossEncoder 模型 |
| QwenRerankEmbeddings | 本地 | 经 transformers 的 Qwen3-Reranker |
| OpenAPIRerankEmbeddings | API | 兼容 OpenAI 风格 rerank API |
| RRFRanker | 算法 | 倒数排名融合,合并多源结果 |
| DefaultRanker | 算法 | 按分数简单排序 |
知识源
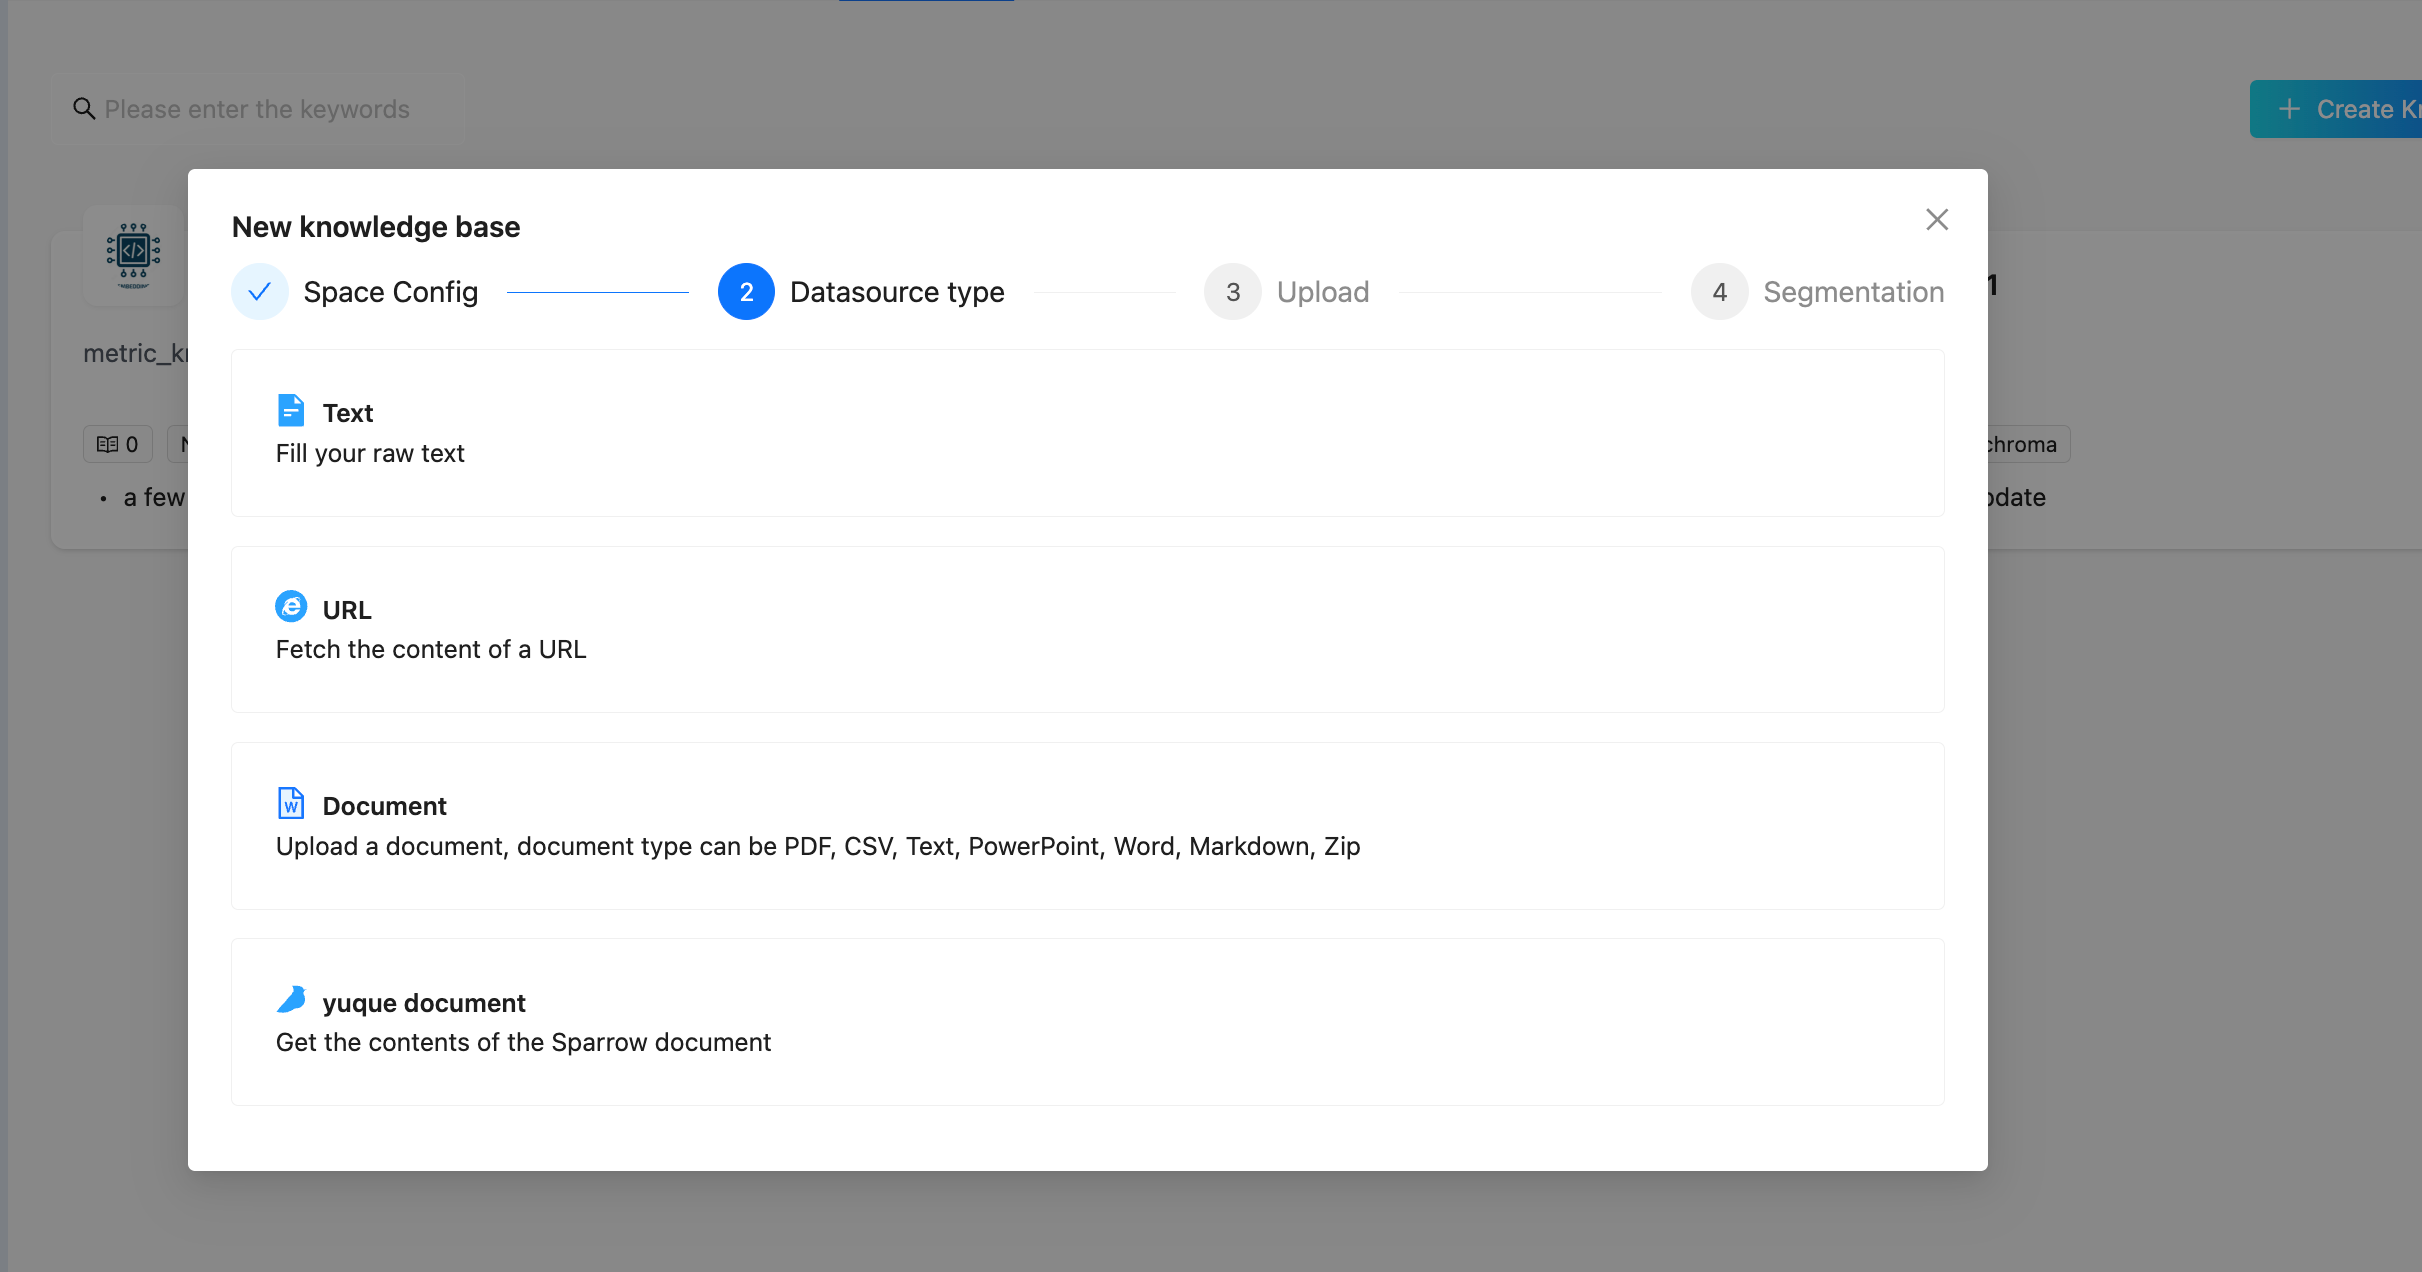
DB-GPT 支持从多种类型的源加载知识。Web UI 上传时可选数据源类型:
数据源类型
| 类型 | 描述 | 例子 |
|---|---|---|
| Document | 上传各种格式文件 | PDF、Word、Excel、CSV、Markdown、PowerPoint、TXT、HTML、JSON、ZIP |
| URL | 抓取并索引网页内容 | 任意可访问 HTTP/HTTPS URL |
| Text | 直接输入原始文本 | 在 UI 里粘贴文本 |
| Yuque | 从语雀导入 | 语雀文档链接 |
| Git Repo | 克隆代码仓库并索引为代码图谱 | GitHub/GitLab 仓库 URL |
支持的文档格式
| 格式 | 扩展名 | Knowledge 类 |
|---|---|---|
.pdf | PDFKnowledge | |
| CSV | .csv | CSVKnowledge |
| Markdown | .md | MarkdownKnowledge |
| Word (docx) | .docx | DocxKnowledge |
| Word (旧版) | .doc | Word97DocKnowledge |
| Excel | .xlsx | ExcelKnowledge |
| PowerPoint | .pptx | PPTXKnowledge |
| 纯文本 | .txt | TXTKnowledge |
| HTML | .html | HTMLKnowledge |
| JSON | .json | JSONKnowledge |
| 代码 | .py .java .js .ts .go .rs .c .cpp … | CodeFileKnowledge(用 tree-sitter 解析进代码图谱) |
存储类型
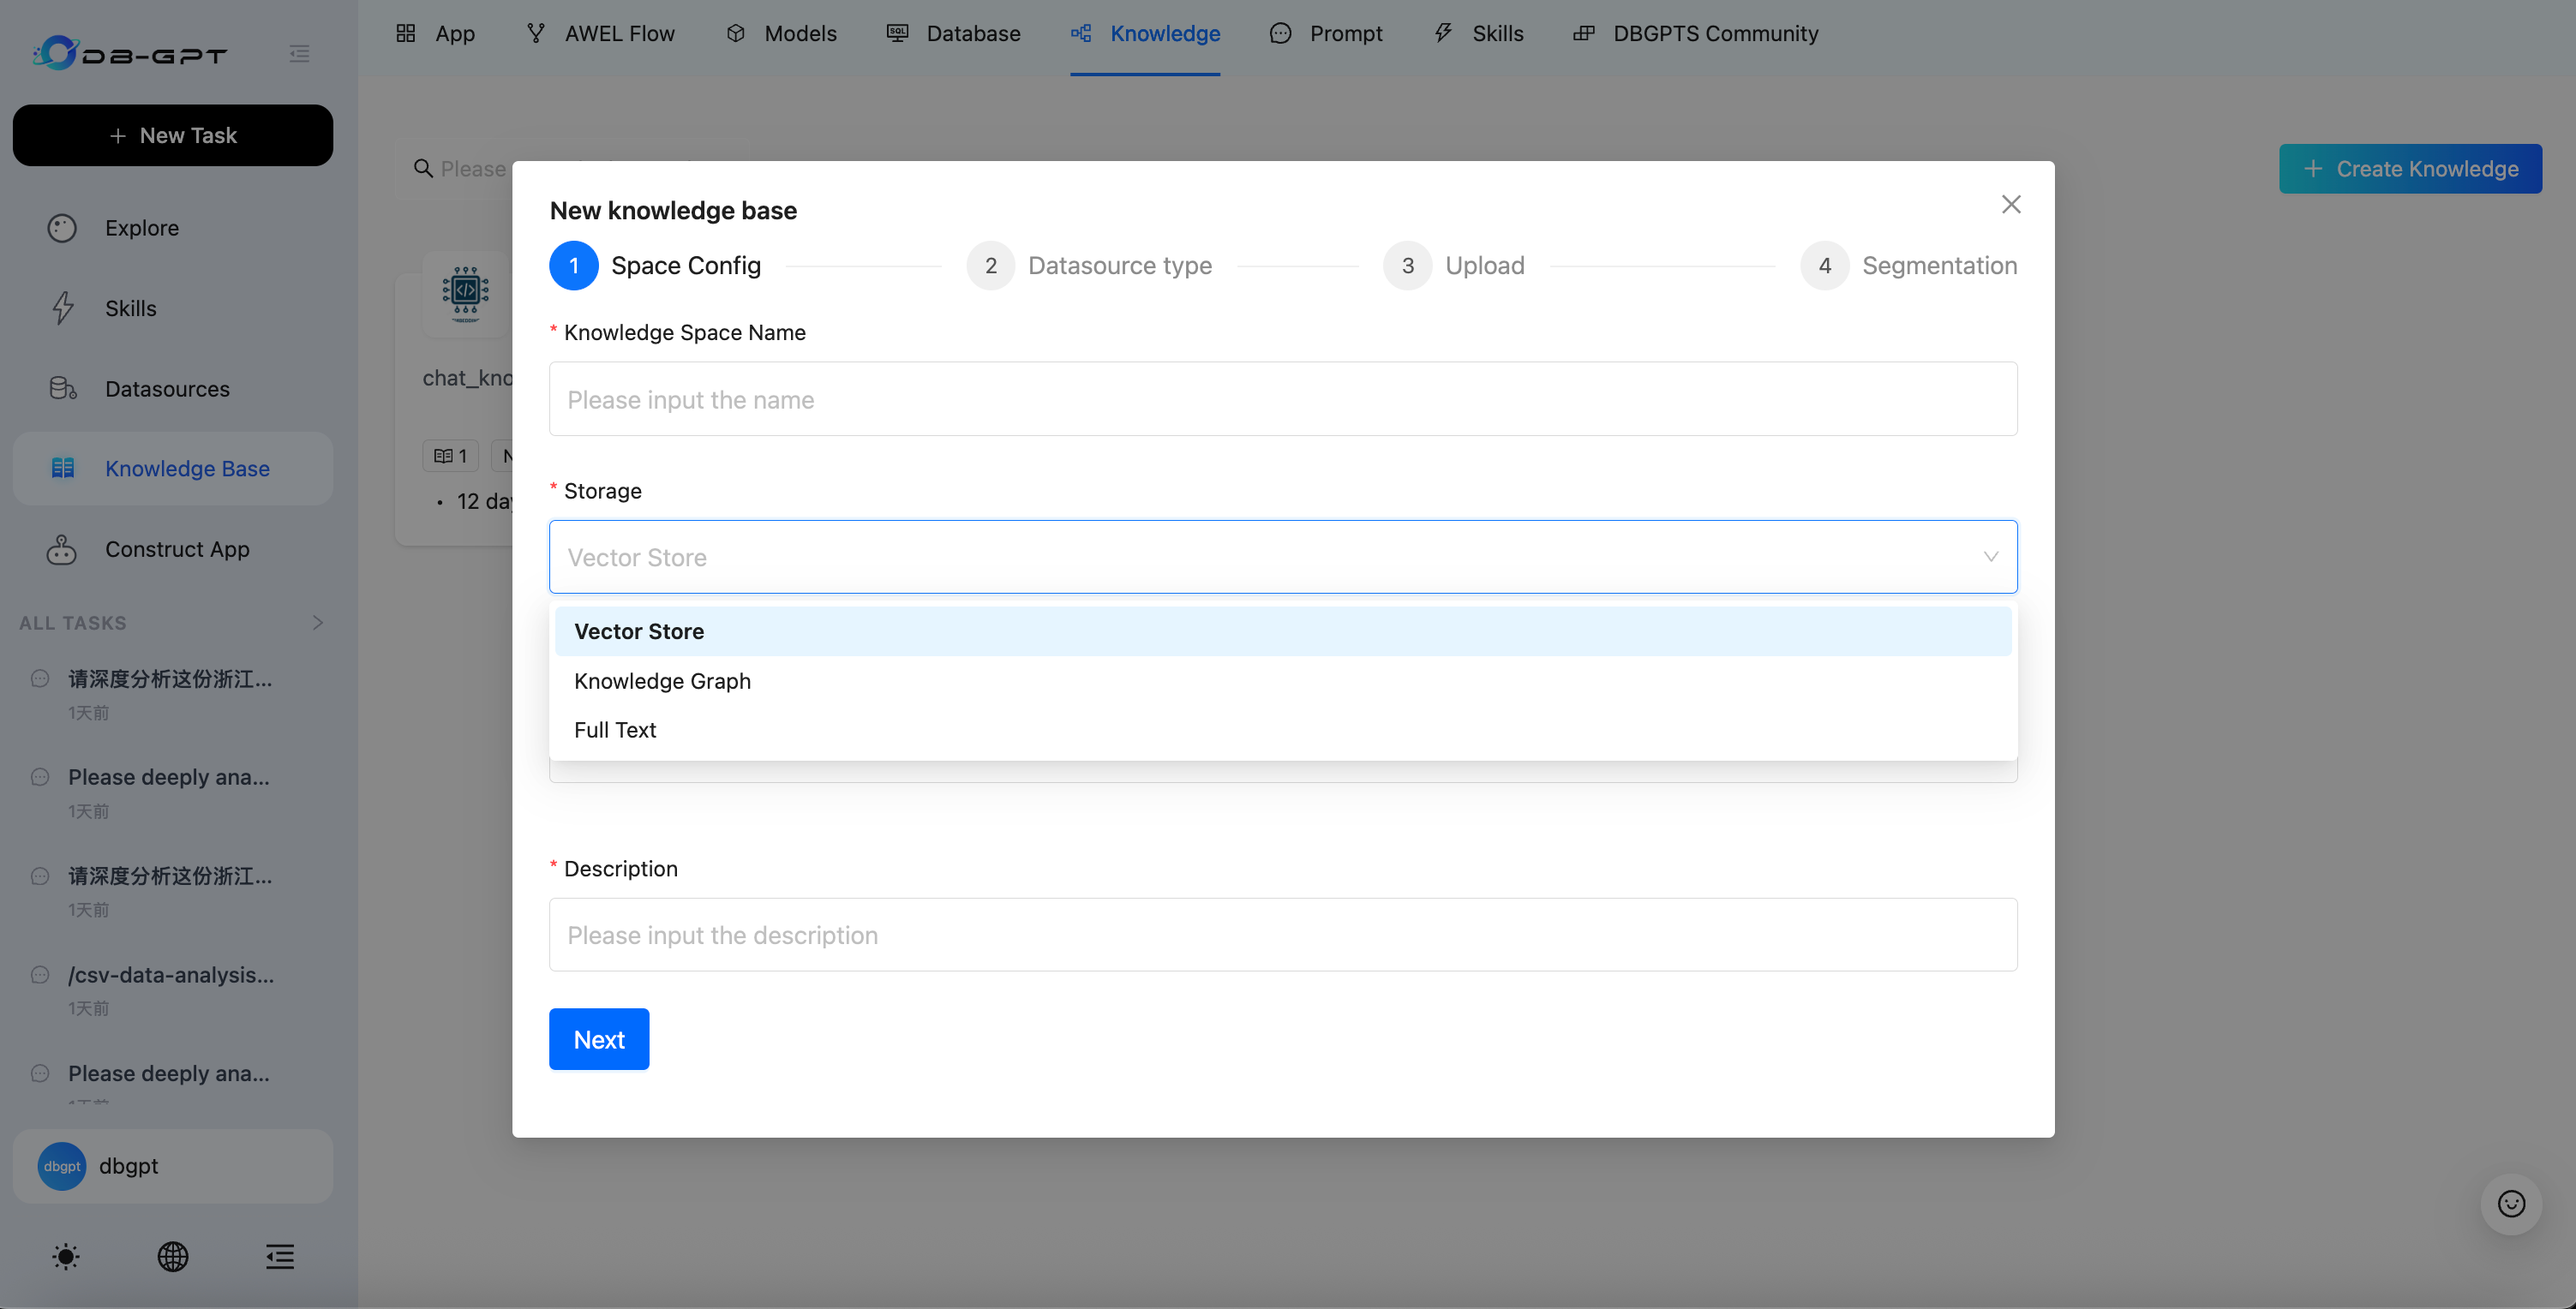
创建知识库时选择用哪些索引存储——可多选,互补:
| 存储类型 | index_methods | 描述 | 最适合 |
|---|---|---|---|
| Vector Store | VectorStore | 存 embedding 做语义相似度检索 | 通用文档问答 |
| Knowledge Graph | KnowledgeGraph | 构建图谱族(LLM 三元组 + 文档/标题/代码结构)做关系型检索 | 实体关系复杂、含代码或结构化文档的领域知识 |
| Full Text | FullText | 全文/BM25 索引做关键词检索 | 精确词匹配、关键词搜索 |
向量库后端
| 后端 | 描述 | 安装 extra |
|---|---|---|
| ChromaDB | 默认嵌入式向量库,零配置 | storage_chromadb |
| Milvus | 生产级分布式向量库 | storage_milvus |
| PGVector | PostgreSQL 的向量扩展 | storage_pgvector |
| Valkey | 内存型高性能向量库,HNSW/FLAT 索引 | storage_valkey |
| Weaviate | 云原生向量检索引擎 | storage_weaviate |
| Elasticsearch | 全文 + 向量混合检索 | storage_elasticsearch |
| OceanBase | 云原生分布式数据库 | storage_oceanbase |
知识图谱后端
| 后端 | 描述 |
|---|---|
| TuGraph | 蚂蚁集团的高性能图数据库 |
| Neo4j | 流行的开源图数据库 |
| Memgraph | 内存型图数据库,低延迟 |
全文后端
| 后端 | 描述 |
|---|---|
| Elasticsearch | 行业标准全文检索引擎 |
| OpenSearch | AWS 的搜索与分析套件 |
知识图谱 RAG
启用 KnowledgeGraph 索引方法时,DB-GPT 构建的是一组图,而非单张图。它们共用一条构建链路,都支持沿边检索:
- LLM 三元组图 —— 用 LLM 从每个 chunk 抽取
(主语, 谓词, 宾语)三元组,以实体 -边- 实体形式 upsert 进图存储(TuGraph、Neo4j 或 Memgraph)。每条边记得来自哪个 chunk,所以答案仍可溯源。 - 文档-段落图 ——
document → chunk → chunk(include/next边)的结构骨架,让检索能从实体跳到包含它的 chunk 和文档。(启用社区汇总变体时,还会做社区检测并用 LLM 总结每个社区。) - Markdown 标题图 —— 对
.md文件建file → H1 → H2 → H3(contains)层级。这是结构索引的图版本。 - 代码图谱 —— 对代码文件和
GIT_REPO空间,用 tree-sitter 解析(Python/Java/JavaScript/TypeScript/Go/Rust/C/C++),产出function/class/method/interface/struct… 节点和file → defines → node边。这让"apply_anthropic_cache_control定义在哪?"这类代码级问题能精确命中。
retriever 还支持 CALLS/INHERITS/IMPLEMENTS 边,但当前代码图谱 builder 只产出 contains 和 defines。调用链/继承遍历只有在别的 builder 产出过这些边时才有结果。完整细节与该 caveat 见知识库索引原理。
图检索子策略
检索时 GraphRetriever 组合使用多种子策略:
- 关键词 —— 按抽取的关键词匹配图节点
- 向量 —— 对图节点 embedding 做语义相似度
- 文本(Text2GQL) —— 用 LLM 把自然语言转成图查询语言
- 文档 —— 通过文档-图关联检索
切分策略
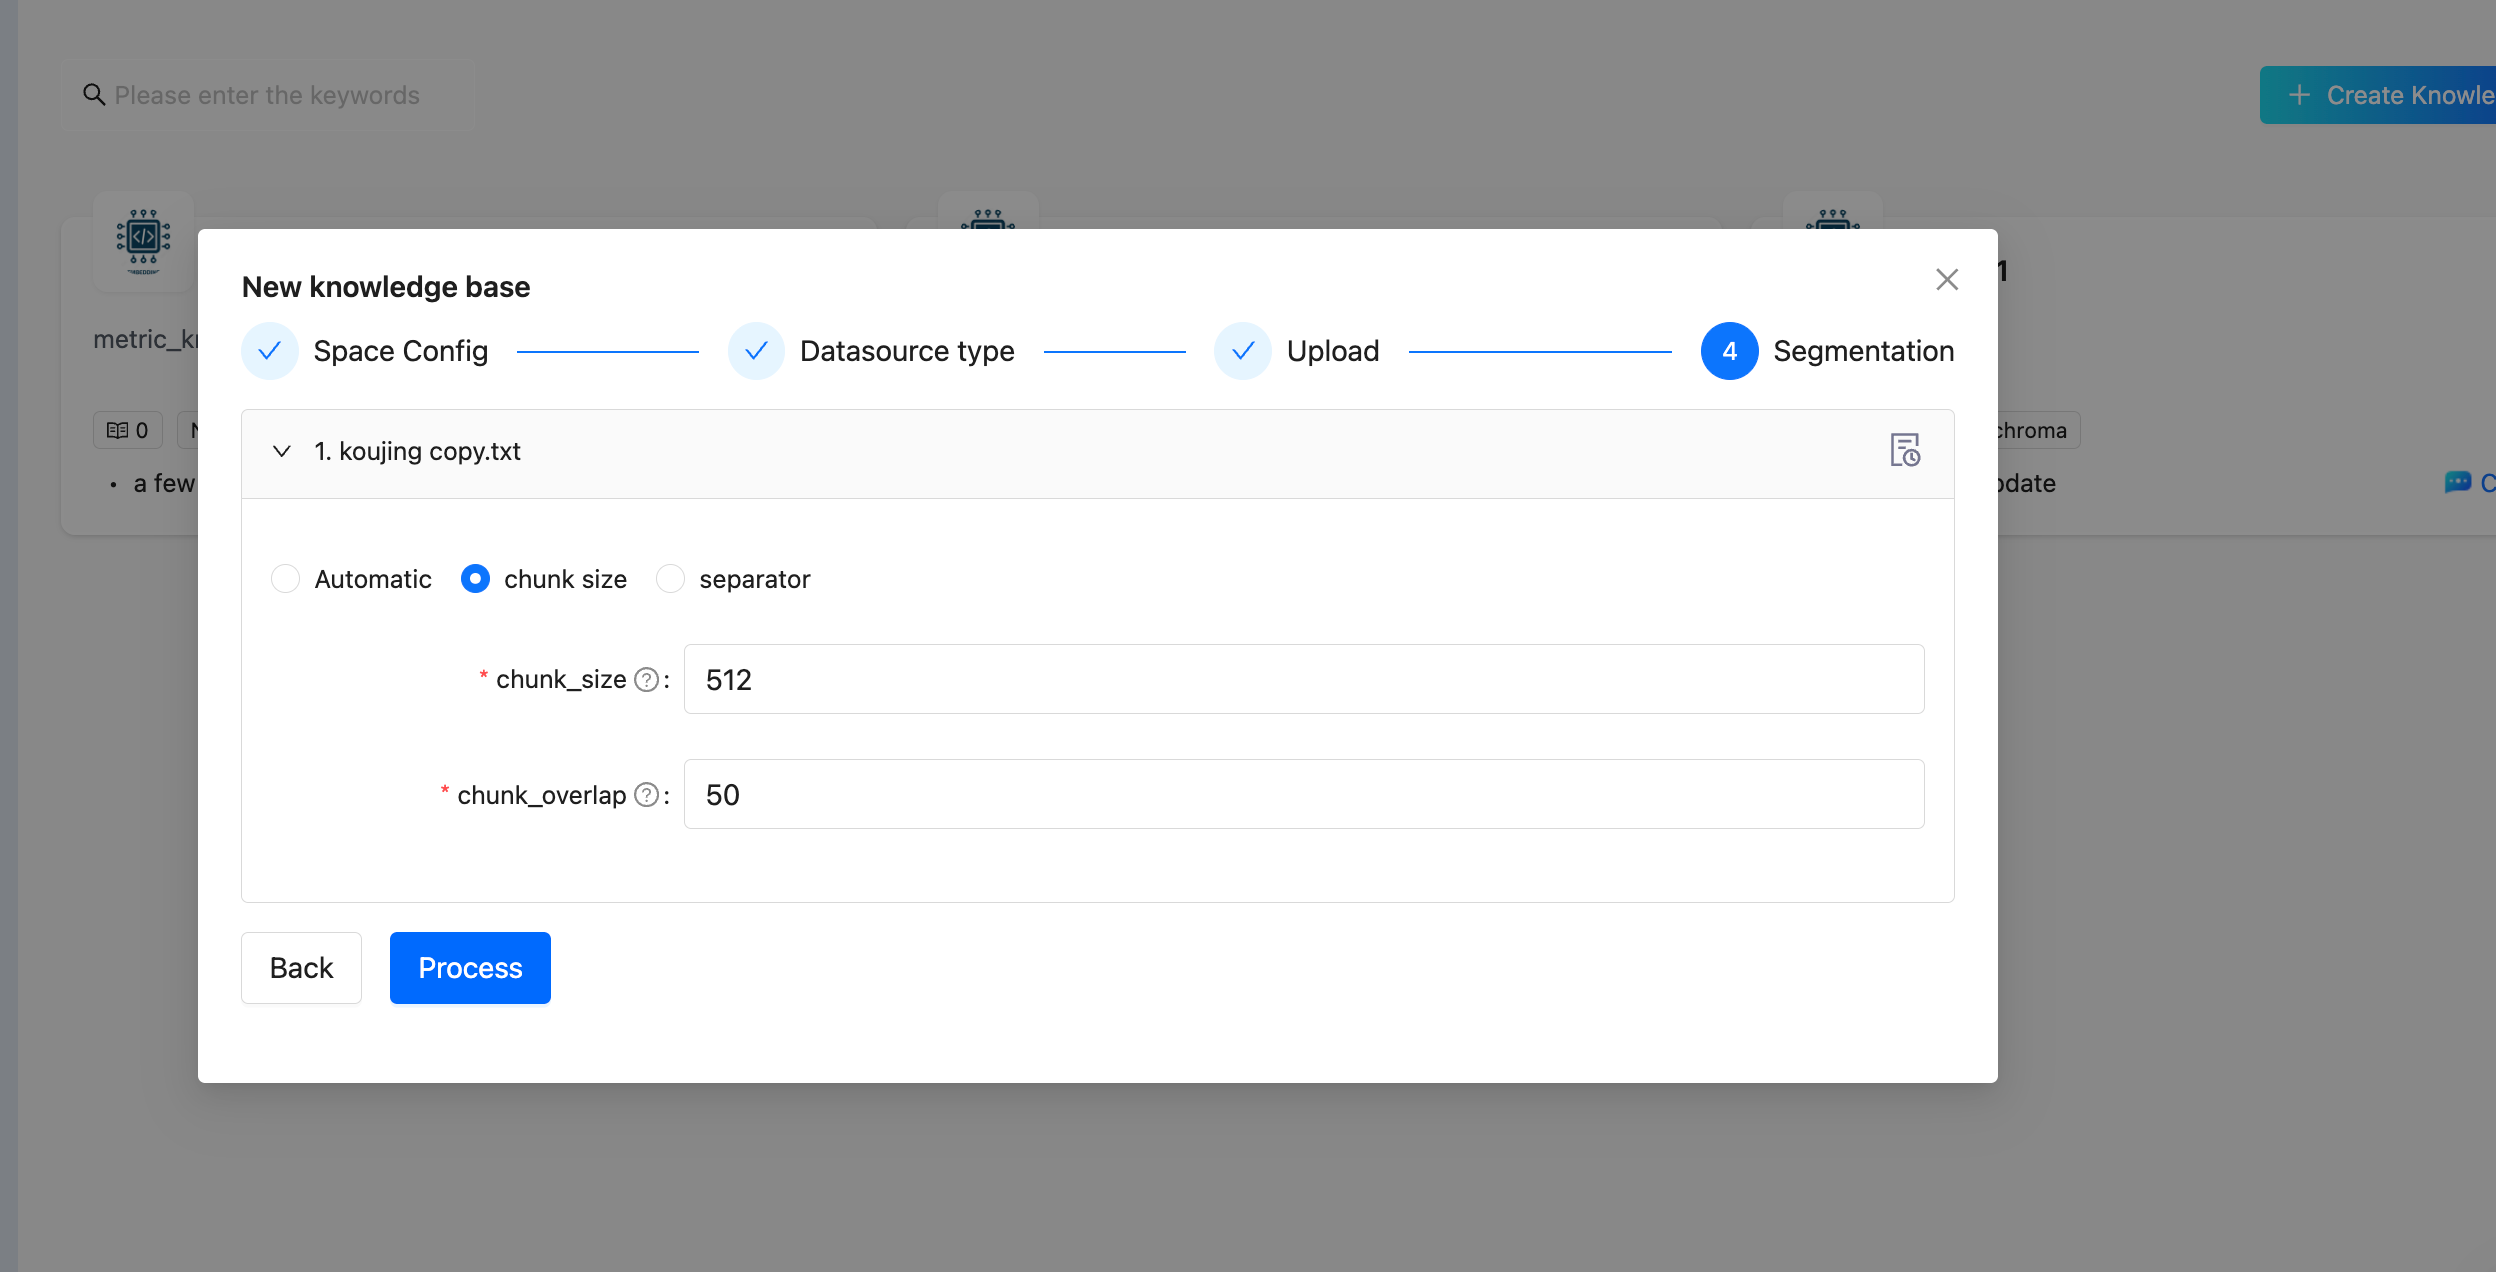
切分是 RAG 质量的关键——它是所有索引的共同地基。DB-GPT 支持多种切分策略:
| 策略 | Splitter | 描述 |
|---|---|---|
| 按大小 | RecursiveCharacterTextSplitter | 按字符数切,可配大小和重叠(默认 512 / 50) |
| 按页 | PageTextSplitter | 按页边界切(适合 PDF) |
| 按段落 | ParagraphTextSplitter | 按段落边界切 |
| 按分隔符 | SeparatorTextSplitter | 按自定义分隔符切 |
| 按 Markdown 标题 | MarkdownHeaderTextSplitter | 按标题层级切,保留标题路径(结构索引和标题图都用它) |
切分参数
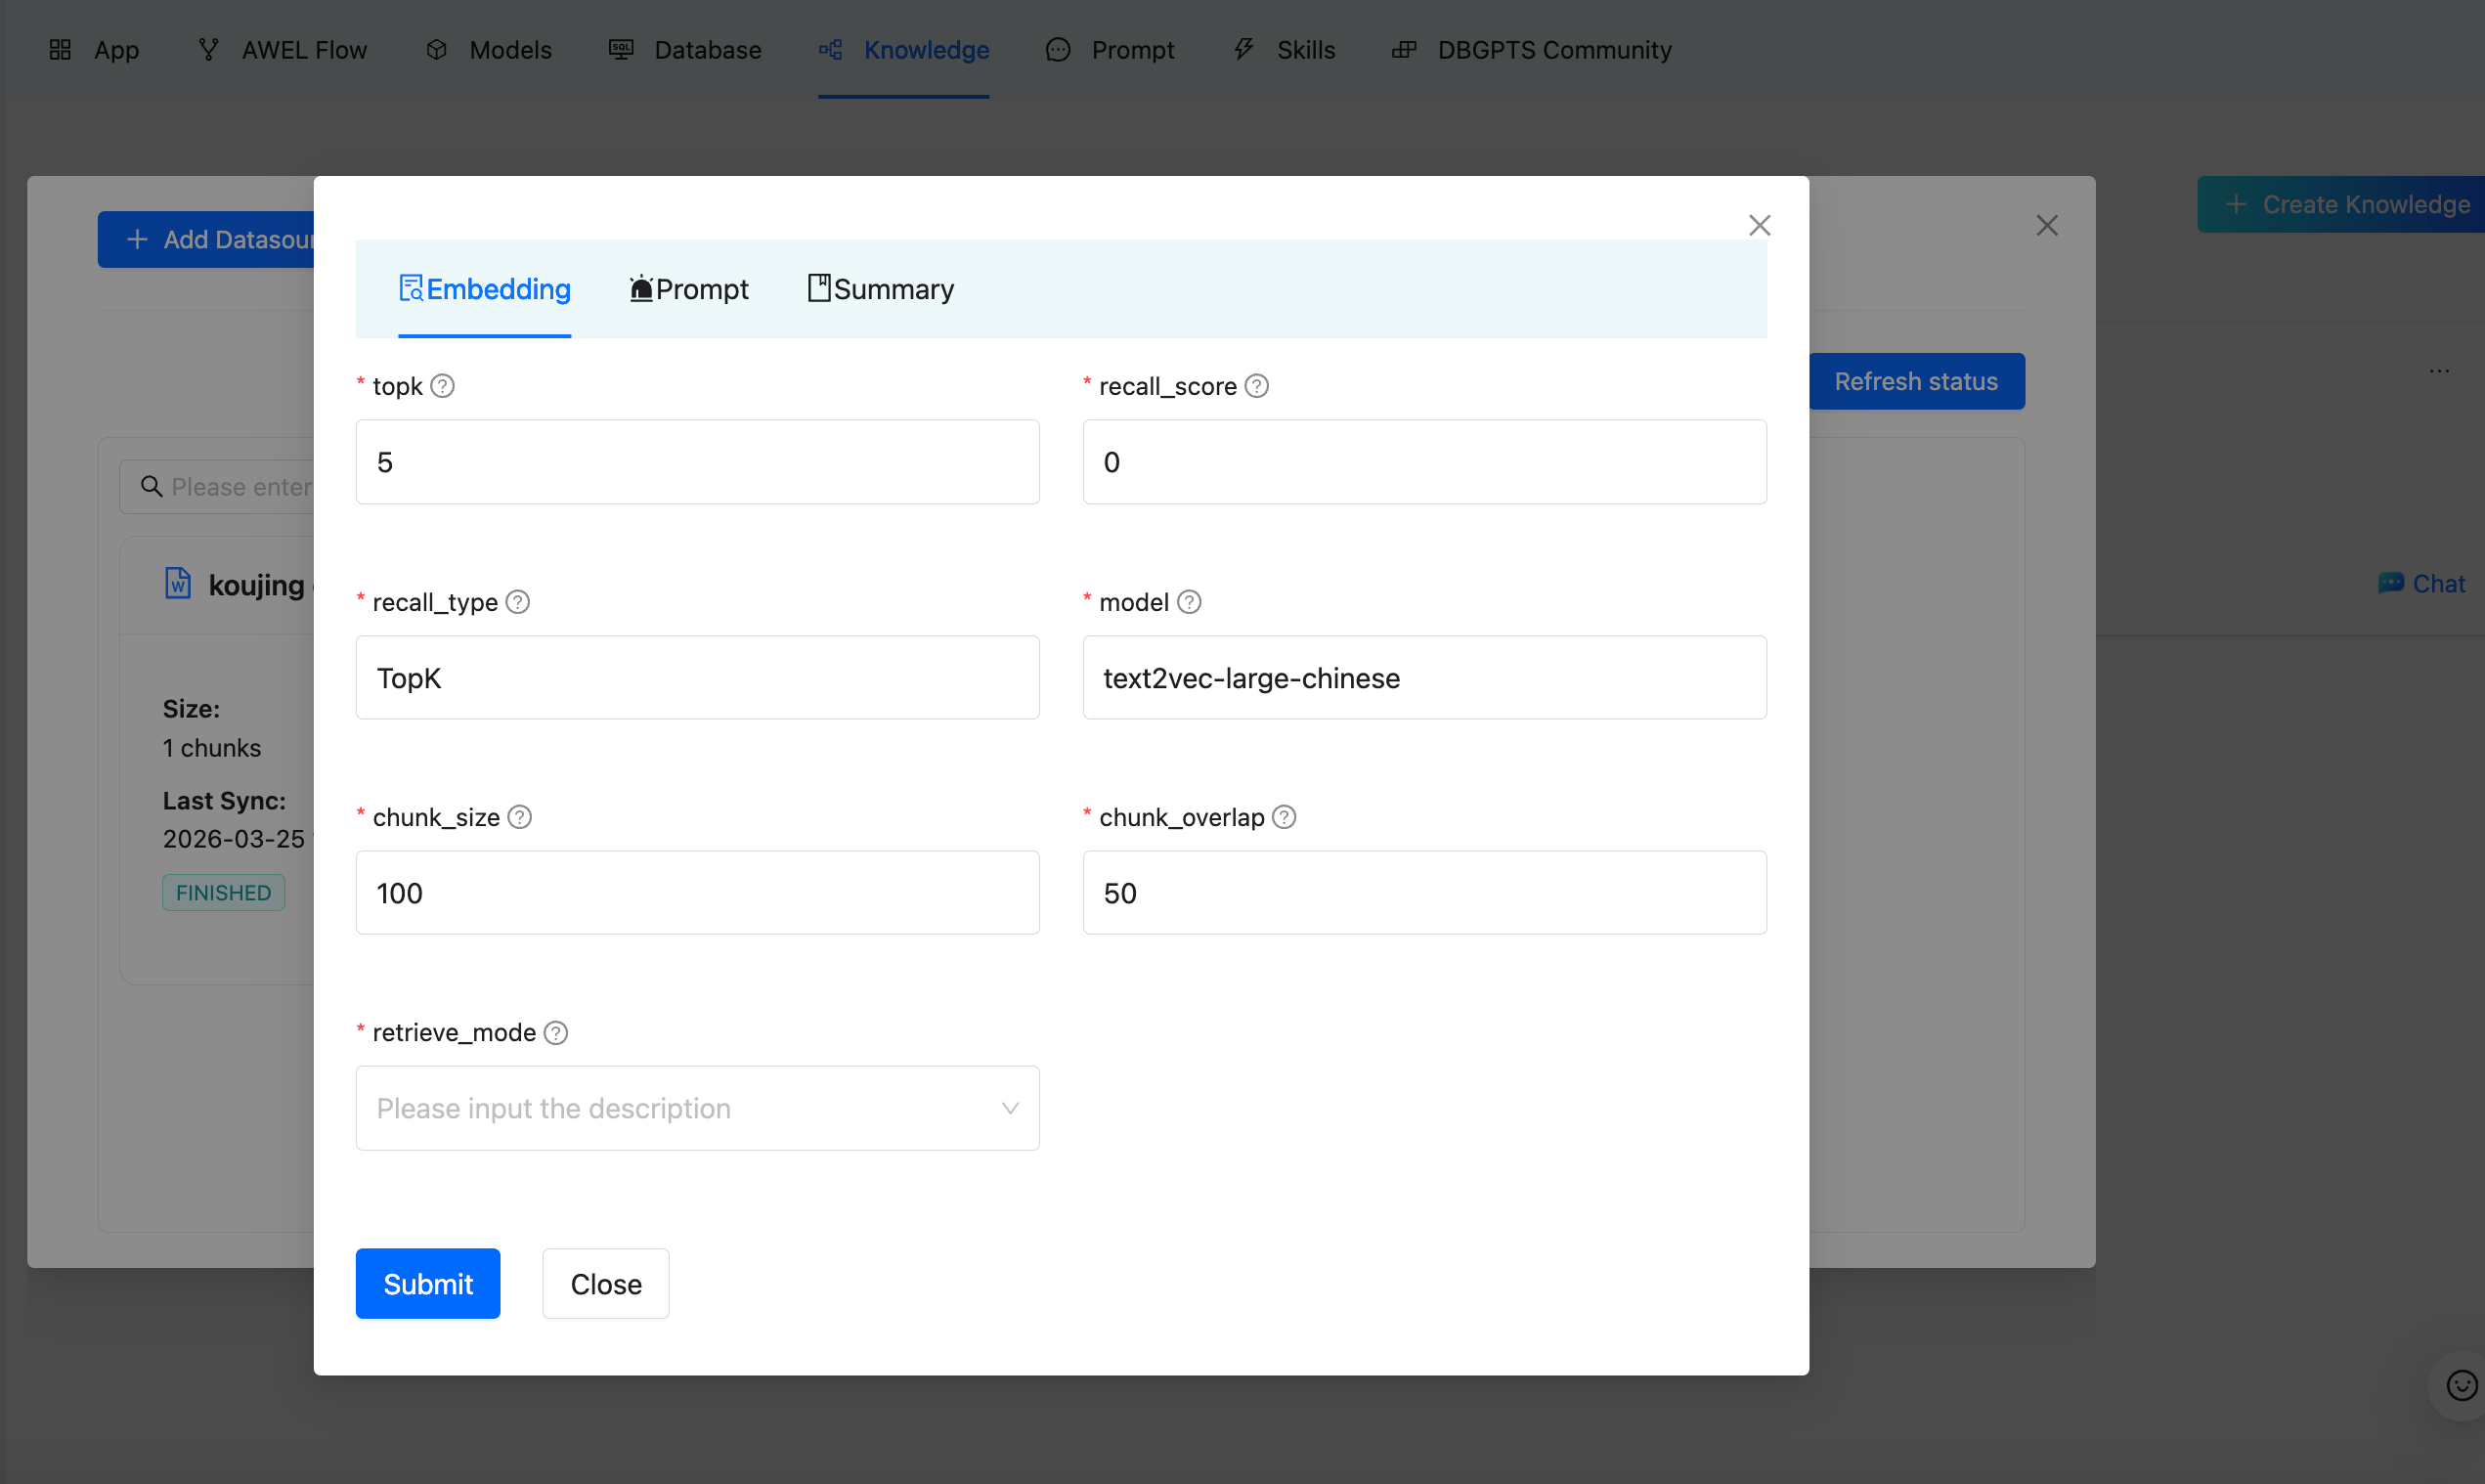
| 参数 | 描述 | 默认 |
|---|---|---|
| chunk_size | 每个 chunk 最大字符数 | 512 |
| chunk_overlap | 相邻 chunk 重叠字符数 | 50 |
| topk | 每次检索取的 chunk 数 | 5 |
| recall_score | 相关度阈值 | 0 |
| recall_type | 召回策略(TopK) | TopK |
| model | 使用的 embedding 模型 | 取决于配置 |
Embedding 模型
DB-GPT 支持多种把文本转向量的 embedding 模型:
本地模型
| 模型 | 类 | 描述 |
|---|---|---|
| HuggingFace | HuggingFaceEmbeddings | 通用 HuggingFace 模型 |
| BGE 系列 | HuggingFaceBgeEmbeddings | BAAI BGE,支持 instruction(中英) |
| Instructor | HuggingFaceInstructEmbeddings | 指令跟随型 embedding |
远程 API 模型
| 提供方 | 类 | 描述 |
|---|---|---|
| OpenAI 兼容 | OpenAPIEmbeddings | 任意 OpenAI 兼容 embedding API |
| Jina | JinaEmbeddings | Jina AI embedding 服务 |
| Ollama | OllamaEmbeddings | 本地 Ollama embedding 服务 |
| 通义(阿里云) | TongyiEmbeddings | 阿里云 DashScope |
| 千帆(百度) | QianfanEmbeddings | 百度文心 |
| SiliconFlow | SiliconFlowEmbeddings | SiliconFlow embedding 服务 |
使用
创建知识库(Web UI)
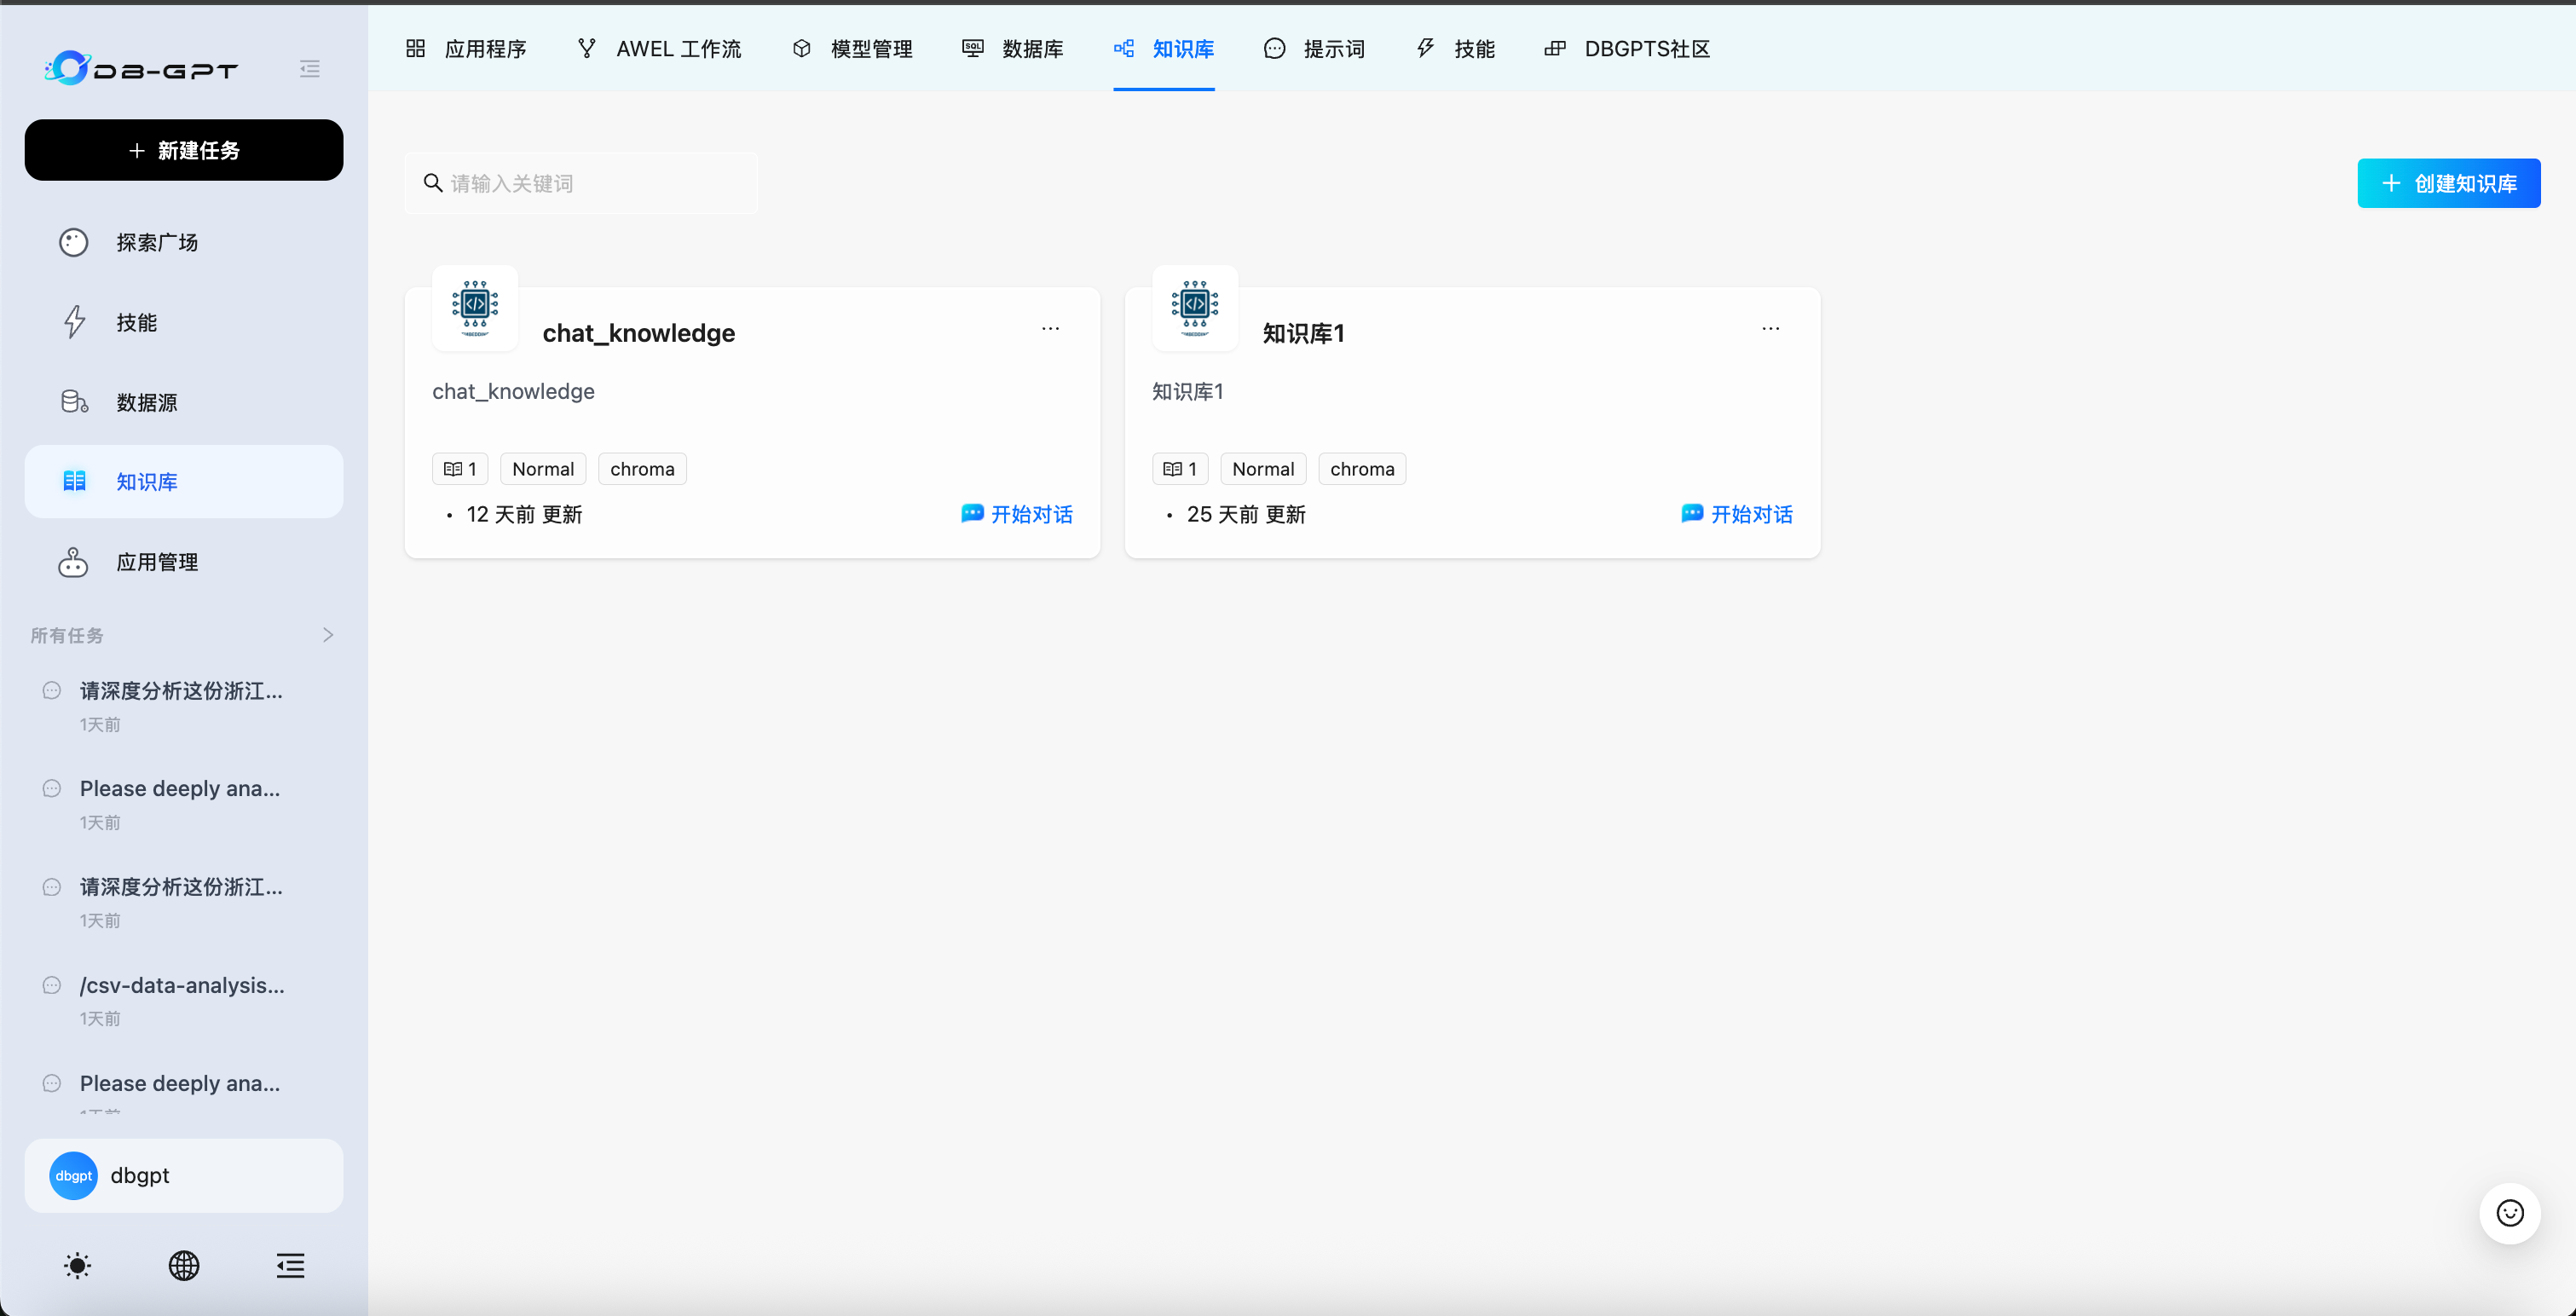
第 1 步 —— 打开知识管理
在侧边栏进入 Knowledge。
第 2 步 —— 创建并配置
- 点击 Create 新建知识库。
- 选择要启用的索引方法(Vector Store / Knowledge Graph / Full Text,可组合)。
- 选择 Embedding 模型并配置切分参数。
第 3 步 —— 上传数据
选择数据源类型并上传内容。支持 Document(PDF、Word、Excel、CSV 等)、URL、Text、Yuque、Git Repo。
第 4 步 —— 配置切分
选择切分策略并设置参数:
第 5 步 —— 配置检索策略(可选)
可配置检索策略。DB-GPT 支持 Semantic / Keyword / Hybrid / Tree 等多种模式,按场景在知识库设置里选择。
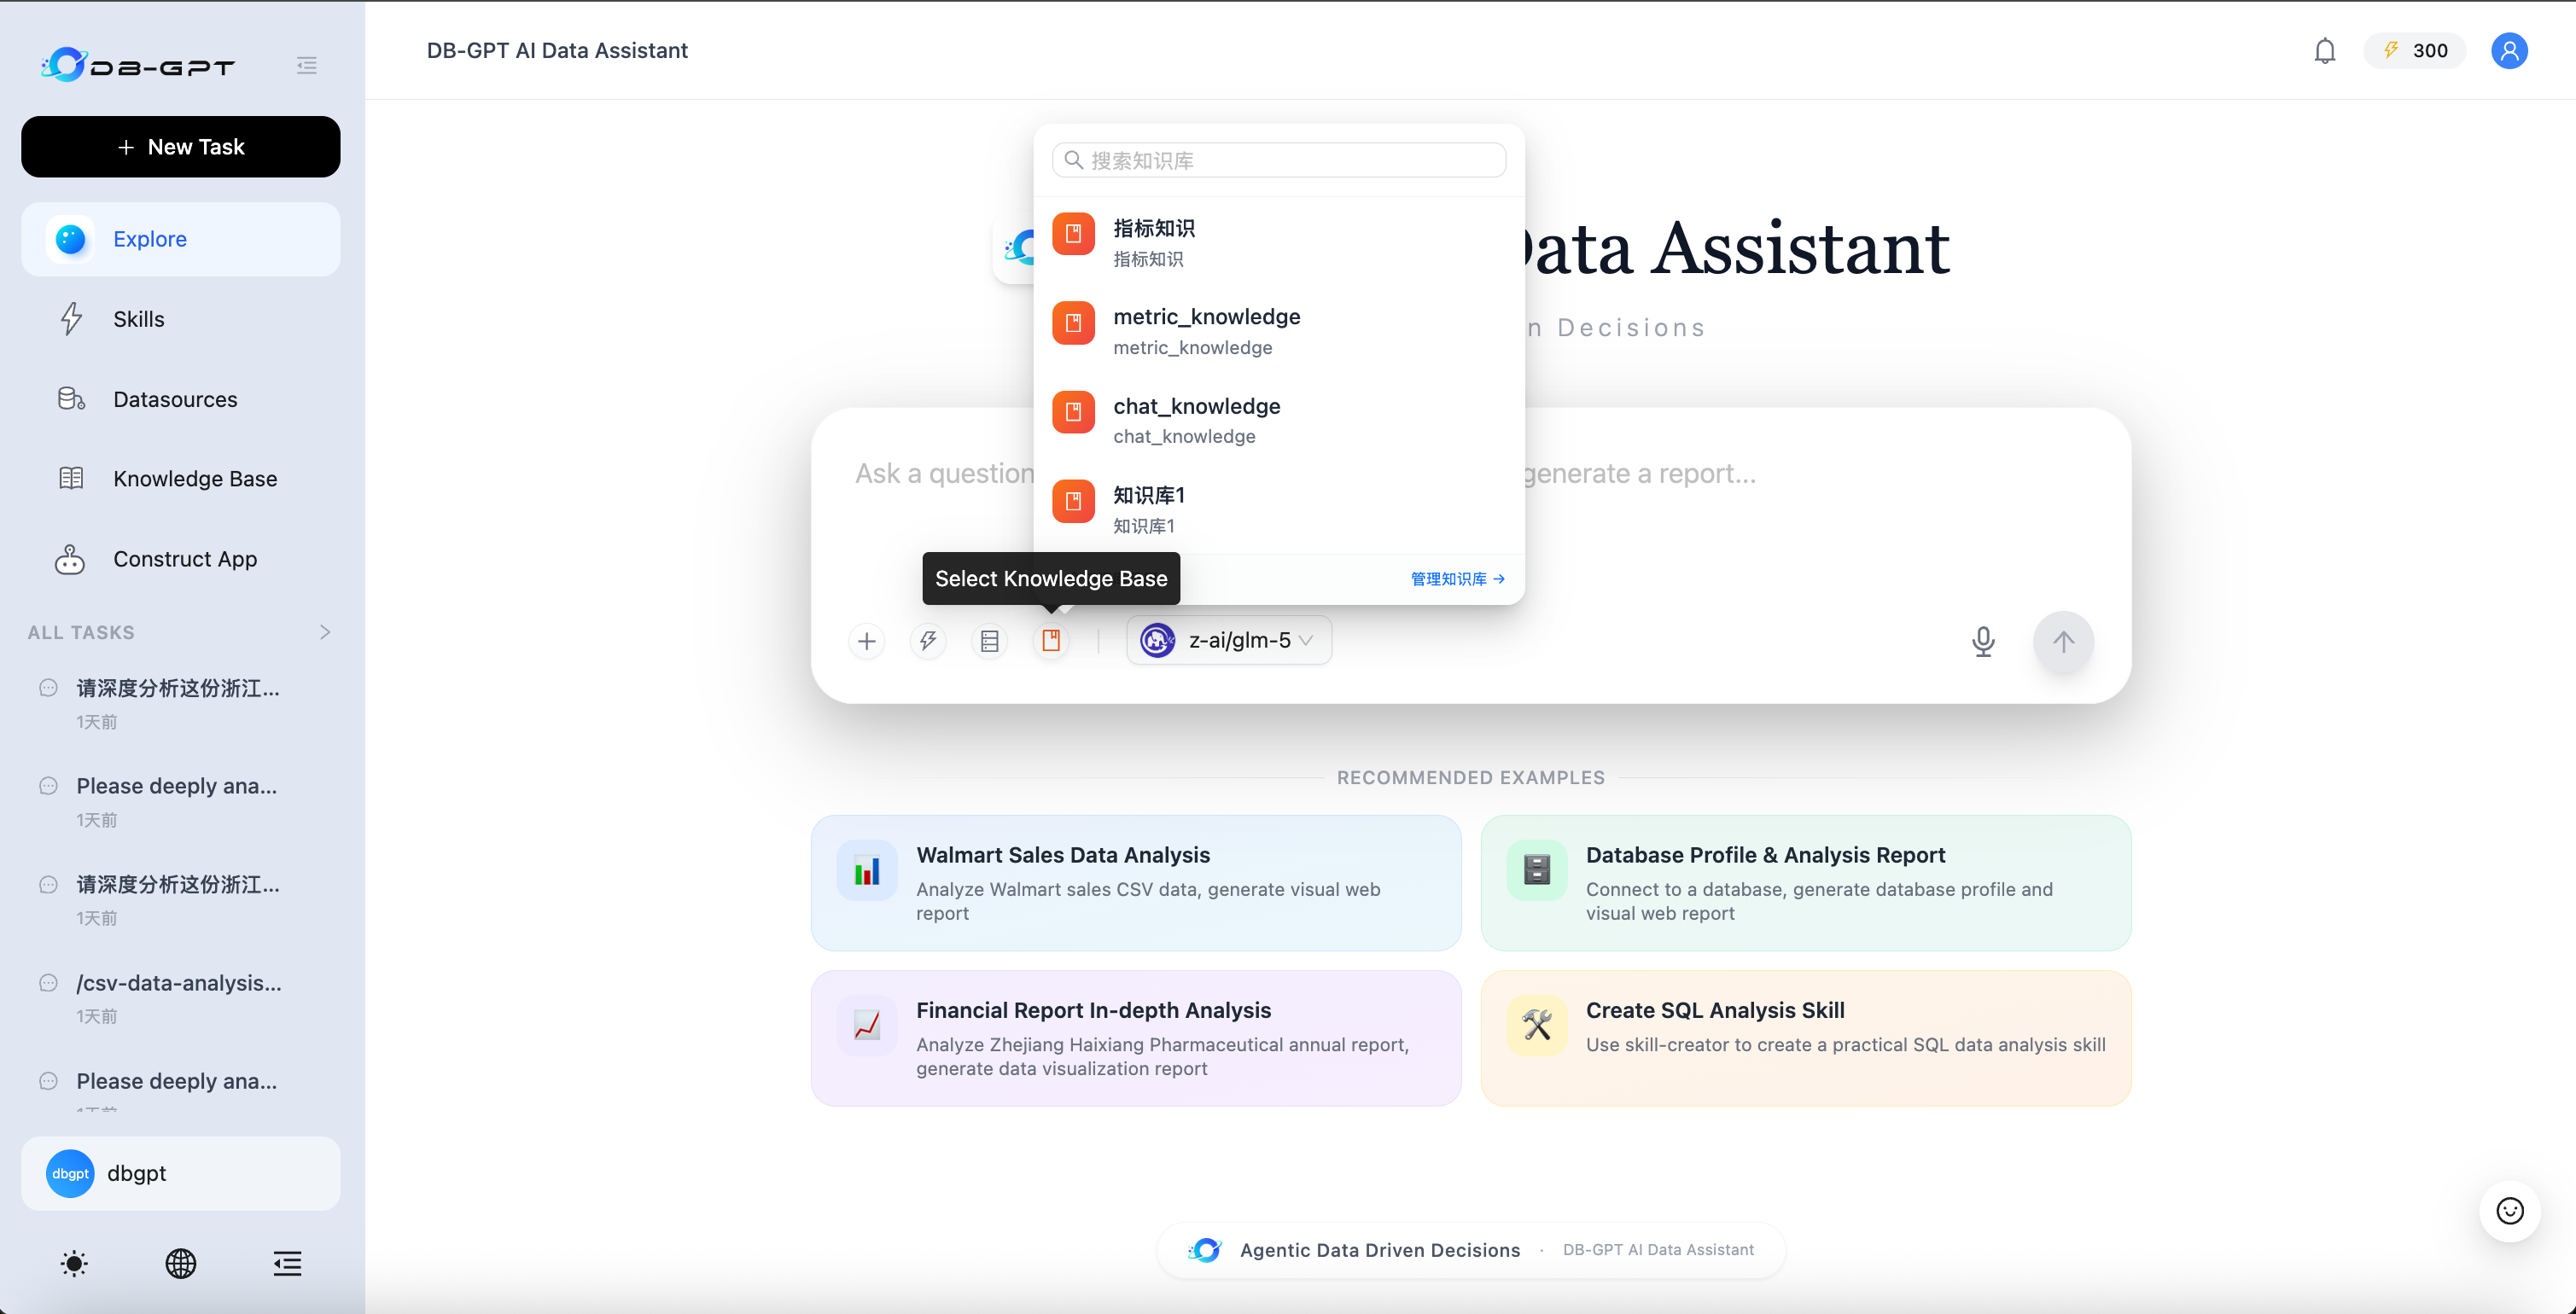
第 6 步 —— 与知识库对话
进入 Chat,点聊天输入栏的知识库图标,下拉选中你的知识库,开始提问。对话即走上述 agentic RAG 循环。
编程使用(Python API)
from dbgpt.rag import Chunk
from dbgpt_ext.rag.assembler import EmbeddingAssembler
from dbgpt_ext.rag.knowledge import KnowledgeFactory

# 抽取:把数据源解析成原始文本
knowledge = KnowledgeFactory.create(file_path="your_document.pdf")

# 转换 + 加载:切分、embedding,并写入向量索引
assembler = await EmbeddingAssembler.aload_from_knowledge(
    knowledge=knowledge,
    index_store=your_vector_store,
    embedding_model=your_embedding_model,
)
assembler.persist()

# 检索(对话时):向量索引回答相似度查询
retriever = assembler.as_retriever(top_k=5)
chunks = await retriever.aretrieve("What is the main topic?")
下一步
| 主题 | 链接 |
|---|---|
| 索引原理(结构 / 知识图谱 / 代码图谱 / 向量 / 关键词) | 知识库索引原理 |
| agentic RAG 对话原理 | Agentic RAG 对话原理 |
| 知识库 Web UI 指南 | Knowledge Base |
| RAG 概念 | RAG |
| Graph RAG 设置 | Graph RAG |
| AWEL RAG 算子 | AWEL |
| 源代码 | GitHub |